本文源自朋友对音频超分辨率的需求,我只是在指导(偶尔提供想法)。后来发现这一套下来效果意外地不错,再加上昨天的更新有点水,于是决定再水一篇。
前言
想必大家对LLM已经并不陌生了,如果没听过LLM的话,AI总该听过的吧。不过我始终觉得以目前的发展情况来说,随机输出猜你想听的话并不意味着智能,说话像人并不意味着这东西也像人(此事在芙莉莲中亦有记载),所以我一直不是很喜欢让LLM放飞自我而自己当甩手掌柜的。也正因如此,我一直反对在LLM训练过程中扮演上帝并引入对齐,同时也一直推崇应当由人类负责任地使用LLM。
众所周知,我的主业是写代码的,在体会到LLM快速的读写速度和信息处理能力之后,自己写代码是不太可能了,顶多娱乐性地把自己的想法写成原型验证,然后让AI去填充细节,比如错误处理、输入检查、文档、单元测试之类的。当然了,大伙也不是来看我怎么用LLM写代码的,所以这个话题先就此略过,最近我在部署本地LLM,目前已经成功部署了Qwen3.8 Flash Next和DeepSeek V4.1 Flash 1017,量化比较重,但性能还行,速度也说得过去,为我降低AI订阅做出了巨大贡献。真要说起来的话,我更偏爱能力弱但能本地部署的模型,而不是随时会被剥夺访问权限的API。当然,这个话题要说起来就长了,不讲不讲,日后再说。
说到我朋友的案例,他不是程序员,所以对技术方面的事情不甚精通。虽然我本人对DeepSeek Harness颇有微辞,认为它不如我常用的OpenCode好使,但从另一方面来说,DSH确实简单易用,和官方API联动的门槛很低,这也使得普通人更容易在聊天框之外用到Agent。我自己也有部署Open WebUI,基本上和网页端的GPT差不多,但这种只限对话式的交互,就算是搭配EXA、GitHub之类的MCP,充其量也只能做一些想法验证、信息搜集之类的活儿。如果你想让它调试个bug或找出软件不能用的原因,那就只能口述,外加一大堆复制粘贴了。而Agentic的好处就是它可以在你的电脑上执行操作,对于调试或部署一个软件,你可以直接告诉它软件在哪,从哪下载,然后它就可以自动地帮你在电脑上做事。非常的方便,就算是普通人也能够驾驭(如果多加小心的话)。
简述
这一次的起因是朋友下载了soundcloud上一首钢琴曲,但音质不佳,听起来发闷,于是想要试试看通过AudioSR进行超采样,将压缩掉的信息补全。但从实际效果来看,AudioSR的输出听起来有些奇怪,朋友的评价是高频有些刺耳,我的评价是高频听起来有些杂(音调不纯,不像是钢琴发出来的声音)。朋友说想要在Audition里调一下,但不知道怎么调,问我,我寻思那我哪知道。但我很快灵机一动,建议他用DSH让DeepSeek给它写几个python脚本做音频处理。
对于在ComfyUI中使用AudioSR进行超采样的部分不在本文的覆盖范围内,这部分是他自己让DSH调试安装的。下面开始是AudioSR输出后,按我的思路和建议进行调试和修复的过程。
发现问题
修复问题的第一步是发现问题。出于版权原因,我不能提供原始文件,也出于我比较懒的原因,我懒得上传处理后的音频(因为前阵子把播放器功能删掉了,传了也没法在网页上听),所以这里就只能口述外加一些佐证了。
从我的听觉来说,我感觉高音有点杂,但又不乱,并非是钢琴按错键的那种感觉,也不是钢琴跑调的感觉。基础旋律在调上,但高音部分就觉得不纯。正好看了一下ComfyUI生成的时域频谱图,初见端倪(这里没有保存,这个是后来让DSH画的对比图):
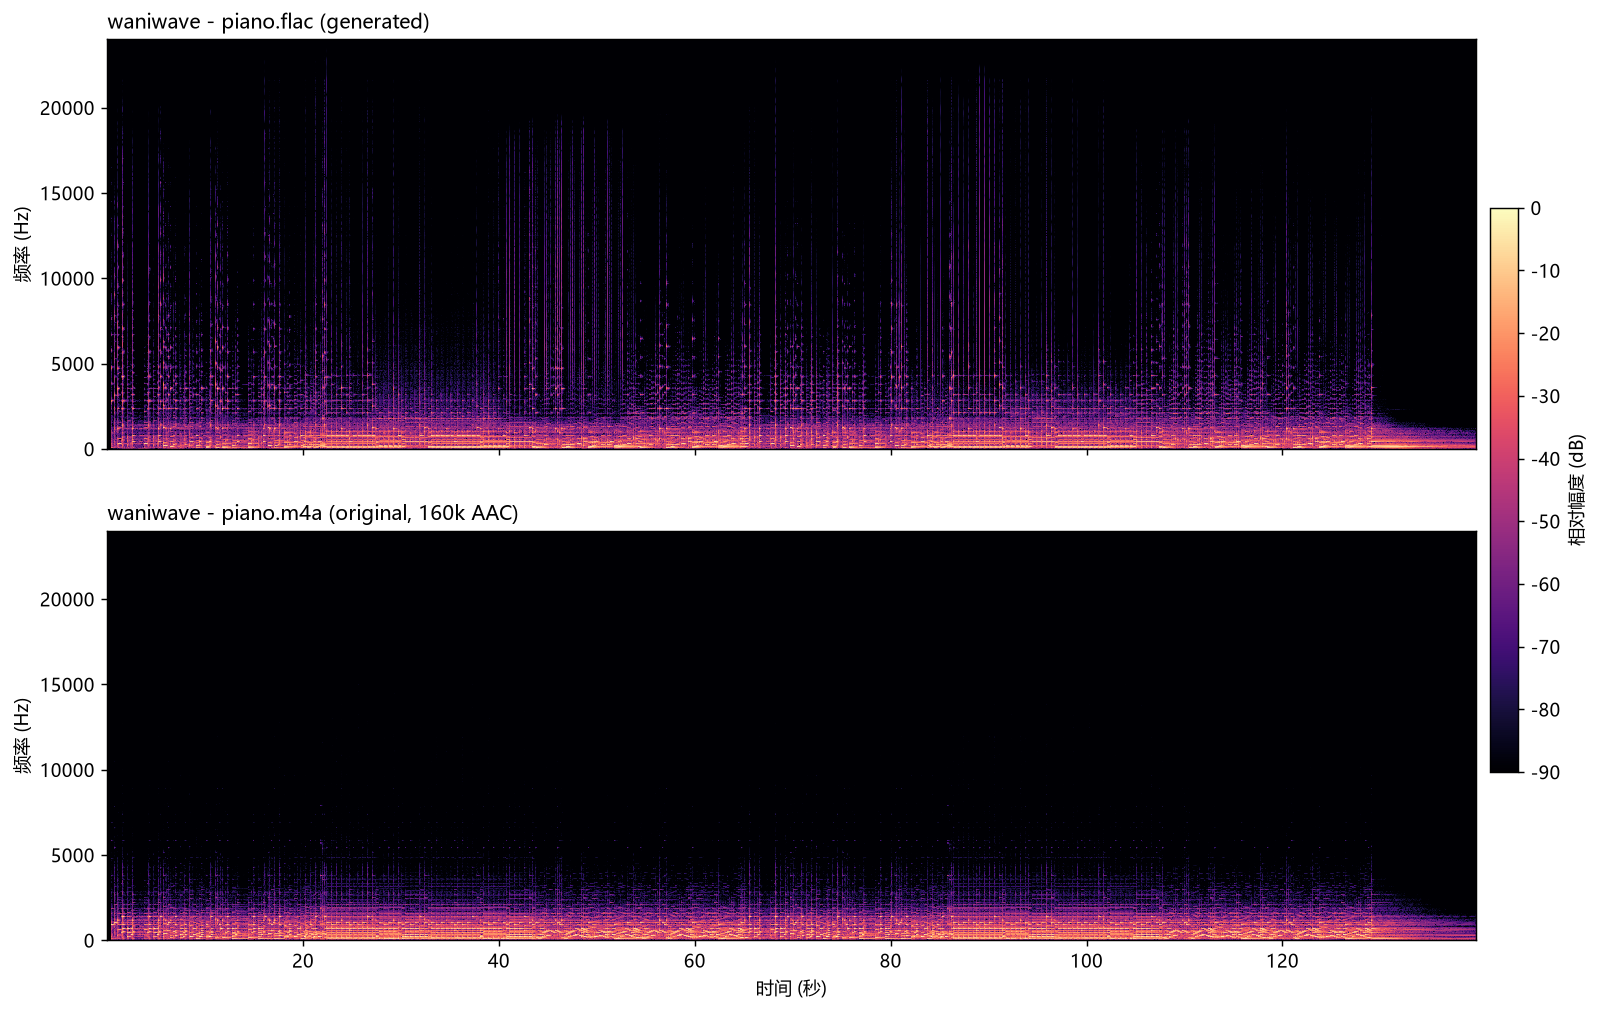
上面是AudioSR的输出,下面是soundcloud上下载的原始文件。可以看到高频的部分确实被补上了,但这也解释了为什么我觉得高频不纯。
我对音乐一无所知,虽然几年前买了钢琴,但确实也没怎么学,之前买的长笛也因为扰民而没能学下去。所以下面是我随便说的,可能不对,别当真
时域频谱图的横轴是时间,纵轴是频率,这样我们就可以确定在某个时间点有哪些频率了。钢琴一个琴键的声音可以近似为单一频率的正弦波,那么经过傅里叶变换,应该只有一个频率分量。考虑到现实中琴弦可能不完美,因此就算有高次谐波,也应该是基础频率的整数倍。但图片中AudioSR生成的波形却有很多明显的竖线。例如40秒后面一点点,其强度从5kHz一直延伸到15kHz,这意味着40秒的时候听众会听到这些频率的正弦波混杂在一起的效果。这也是为什么我觉得高频不纯。
那么确认了方向,那么接下来就要进一步分析要去掉哪些不纯的频率分量了。但线性的不太好看,于是又让朋友告诉DSH,把频率换成对数比例,于是就有了这张图:
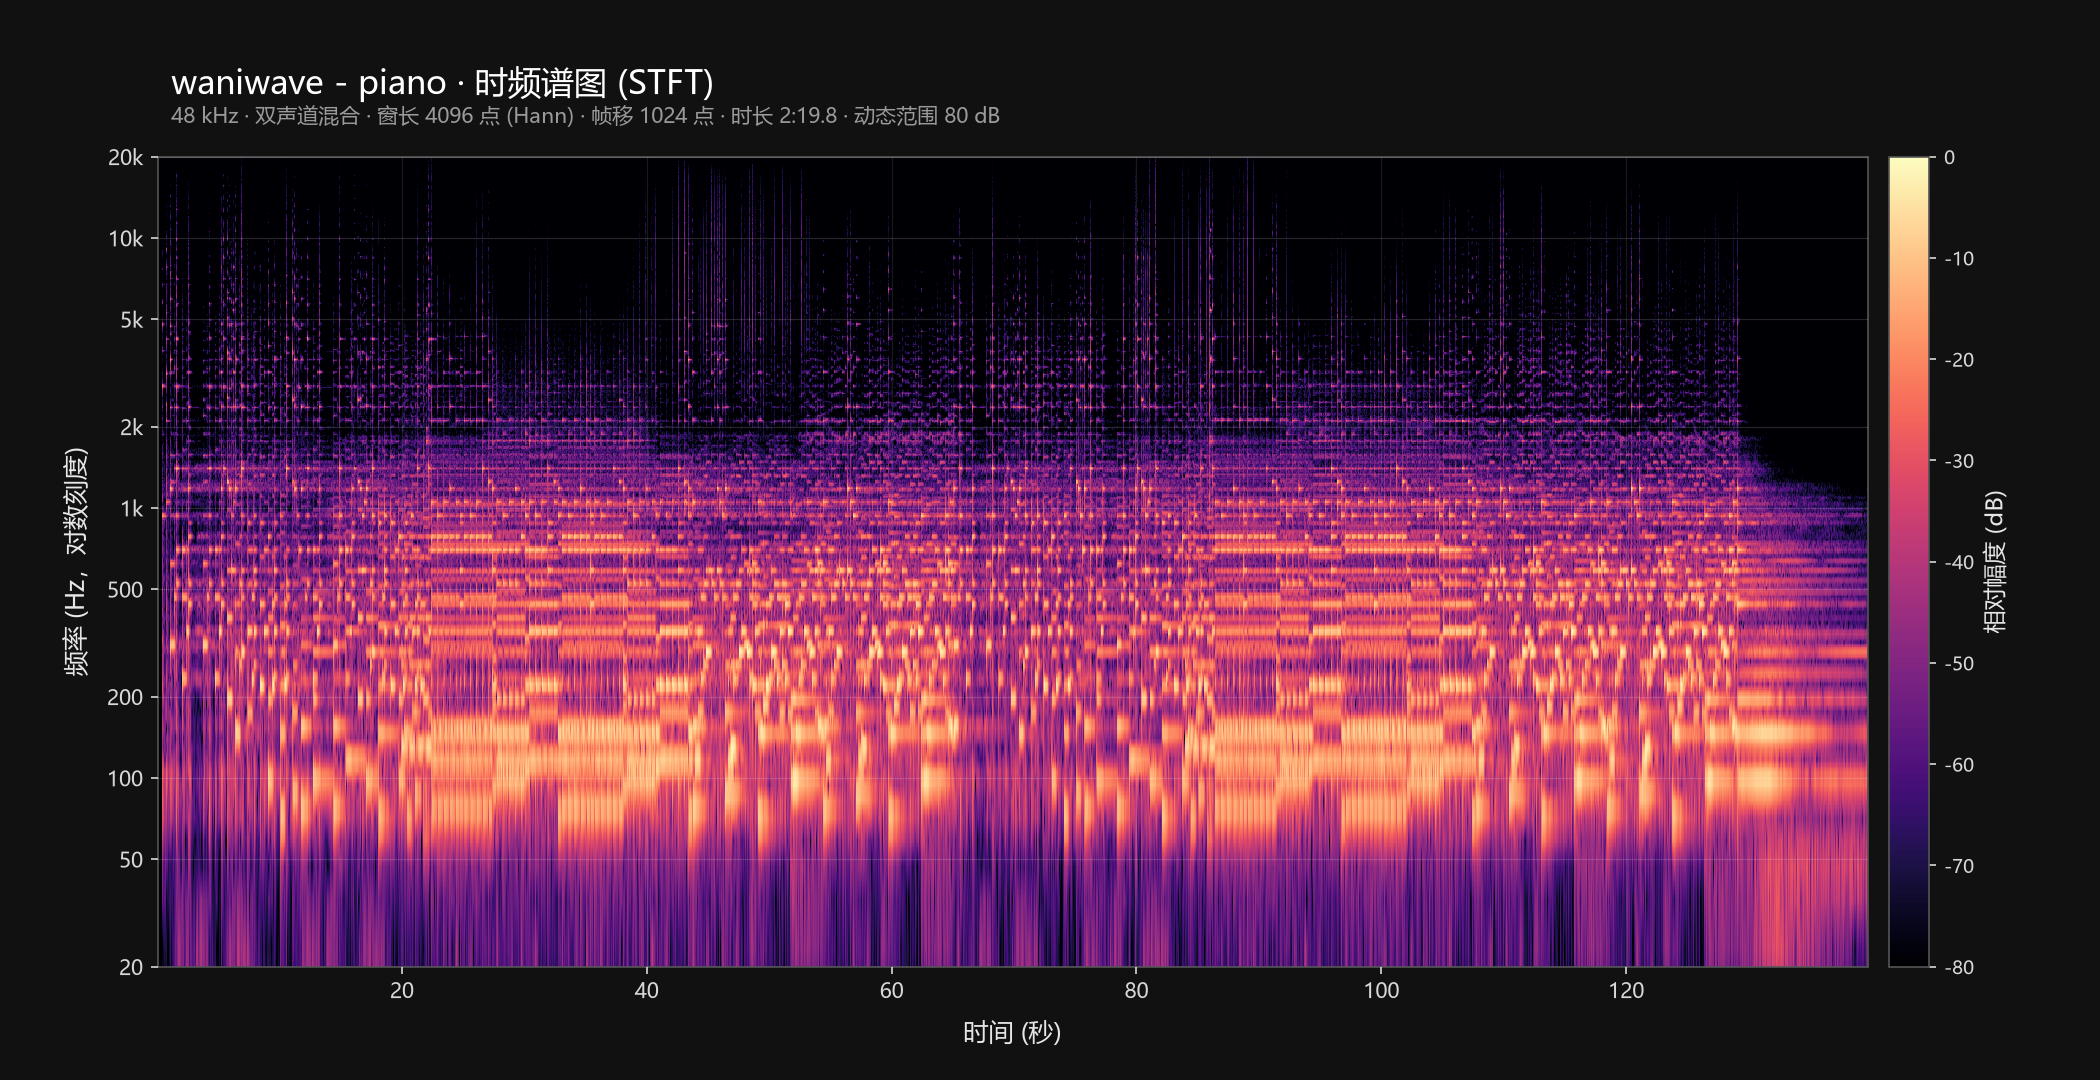
事后分析DSH导出的会话,DeepSeek是这样做的:
- 读取AudioSR输出产物,左右声道先平均为单声道。
STFT:
nperseg=4096、hop=1024、Hann 窗,48 kHz。
- 频率分辨率约
48000/4096 = 11.72 Hz;- 时间步长约
1024/48000 = 21.33 ms;- 共 6548 帧,2049 个线性频率 bin。
- 幅度归一化:
|FFT| * 2 / sum(window);转 dB 后减去全曲最大值,裁剪到 −80 dB。- 频率轴:从 20 Hz 到 20 kHz,插值到 640 个对数均匀频点,再用
pcolormesh+set_yscale("log")绘制。- 配色
magma,深色背景,色阶 80 dB,输出 2100×1080 PNG。- 会话在工作区根目录创建
.venv(Python 3.11.3),安装numpy 2.4.6、matplotlib 3.11.2、soundfile 0.14.0。会话结论:基频主要落在 100–160 Hz(峰值约 105/152 Hz),上方有谐波栈;约 132 s 后进入自然衰减尾音,末段 RMS 从 −21 dBFS 降到 −38 dBFS;全曲峰值约 −7 dBFS,整体 RMS −22.6 dBFS(单声道混合口径)。
第一次尝试
由于我俩都不是音乐专业的,因此不知道该怎么向DeepSeek描述我们的需求。我短暂地思考了一下,给出了一个参考样例:
请你根据时域频谱图的数据,参照原始音频和生成的音频,找出突兀的频率并去掉。突兀的频率是指原始声音中不存在且不应该存在的频率,但处理时意外引入的频率,通常出现在高频频段。请你先编写脚本分析并找出这些频率,然后去掉频率后将新的音频输出保存在xxx.wav中,并对处理后的音频绘制时域频谱图以便对比。
于是就有了第一次处理的结果:
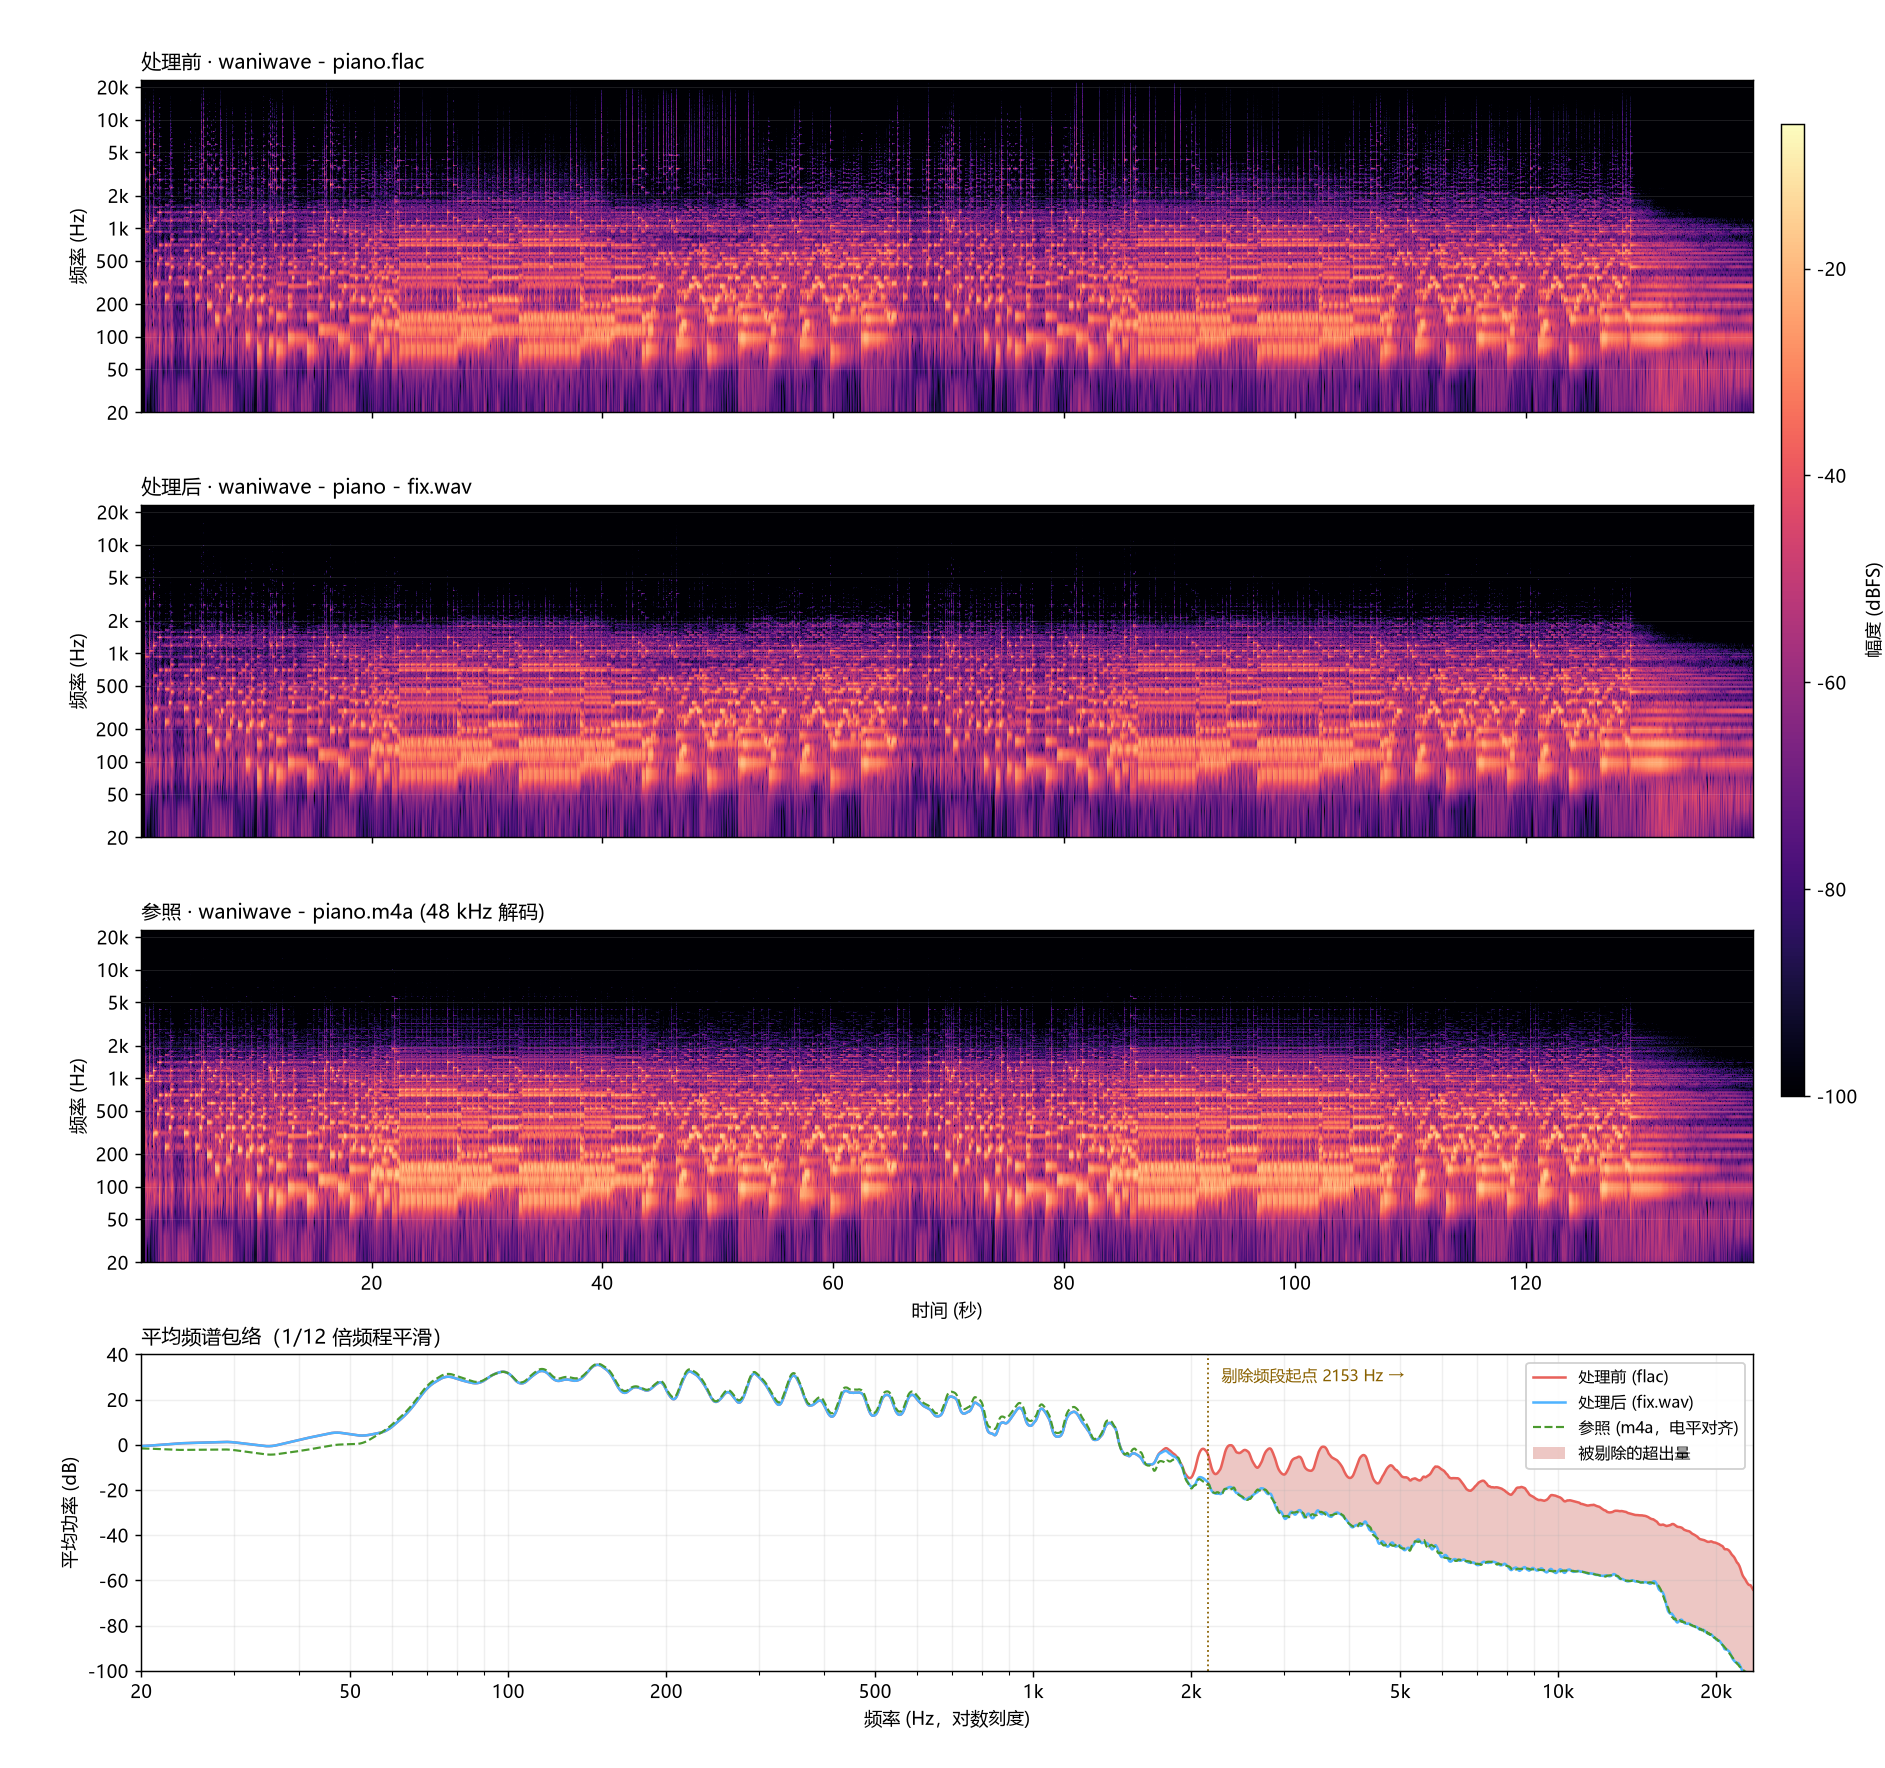
听了一下,结果发现比原始音频更闷了。我一看频谱图,这不对啊,这处理后的频谱图和参照几乎差不多了,甚至高频比参照还少。幸好DeepSeek还贴心地在最下方附上了处理方法,结果发现它这是照着原始音频把原本不存在的高音全都去掉了。我寻思,那AudioSR处理图啥呢?
事后分析,DeepSeek在这一步是这样处理的:
- 在 STFT 域对每一帧做增益:
nper=4096、hop=1024、Hann 窗;增益曲线用10^(gain_db/20)。增益只衰减、不提升:
gain_db = clip(target − dB_flac, −70, 0) * ramp ramp = clip((log2(f / 2153) + 0.30) / 0.60, 0, 1) # 1/3 倍频程斜坡- 因为重叠相加后实测 PSD 不完全等于增益平方,脚本迭代 4 次校正增益;最终残差最大约 5.4 dB(主要在频段边缘的斜坡上)。
- 最大衰减 −45.5 dB,出现在约 21.6 kHz;2.15 kHz 以下完全不动。
- 输出
PCM_16、48 kHz 双声道;峰值 0.5074,未削波。最终结果按1/12 倍频程划分,每个频段的功率都与原始音频差不多。
第二次尝试
有时候LLM没有如我心意,通常是我许愿的时候没说清楚,这次就是。于是第二次尝试我修改了策略,强调这是钢琴曲,要按照钢琴的发声特性处理。这一轮提示词如下:
这是一首钢琴曲,按照钢琴发声的频谱特性处理音频,现在剔除的方法使得处理后的音频比参照音频更加闷。请按照前述的要求重新处理并保存在waniwave - piano - fix-1.wav中,并对处理后的音频绘制时域频谱图以便对比。
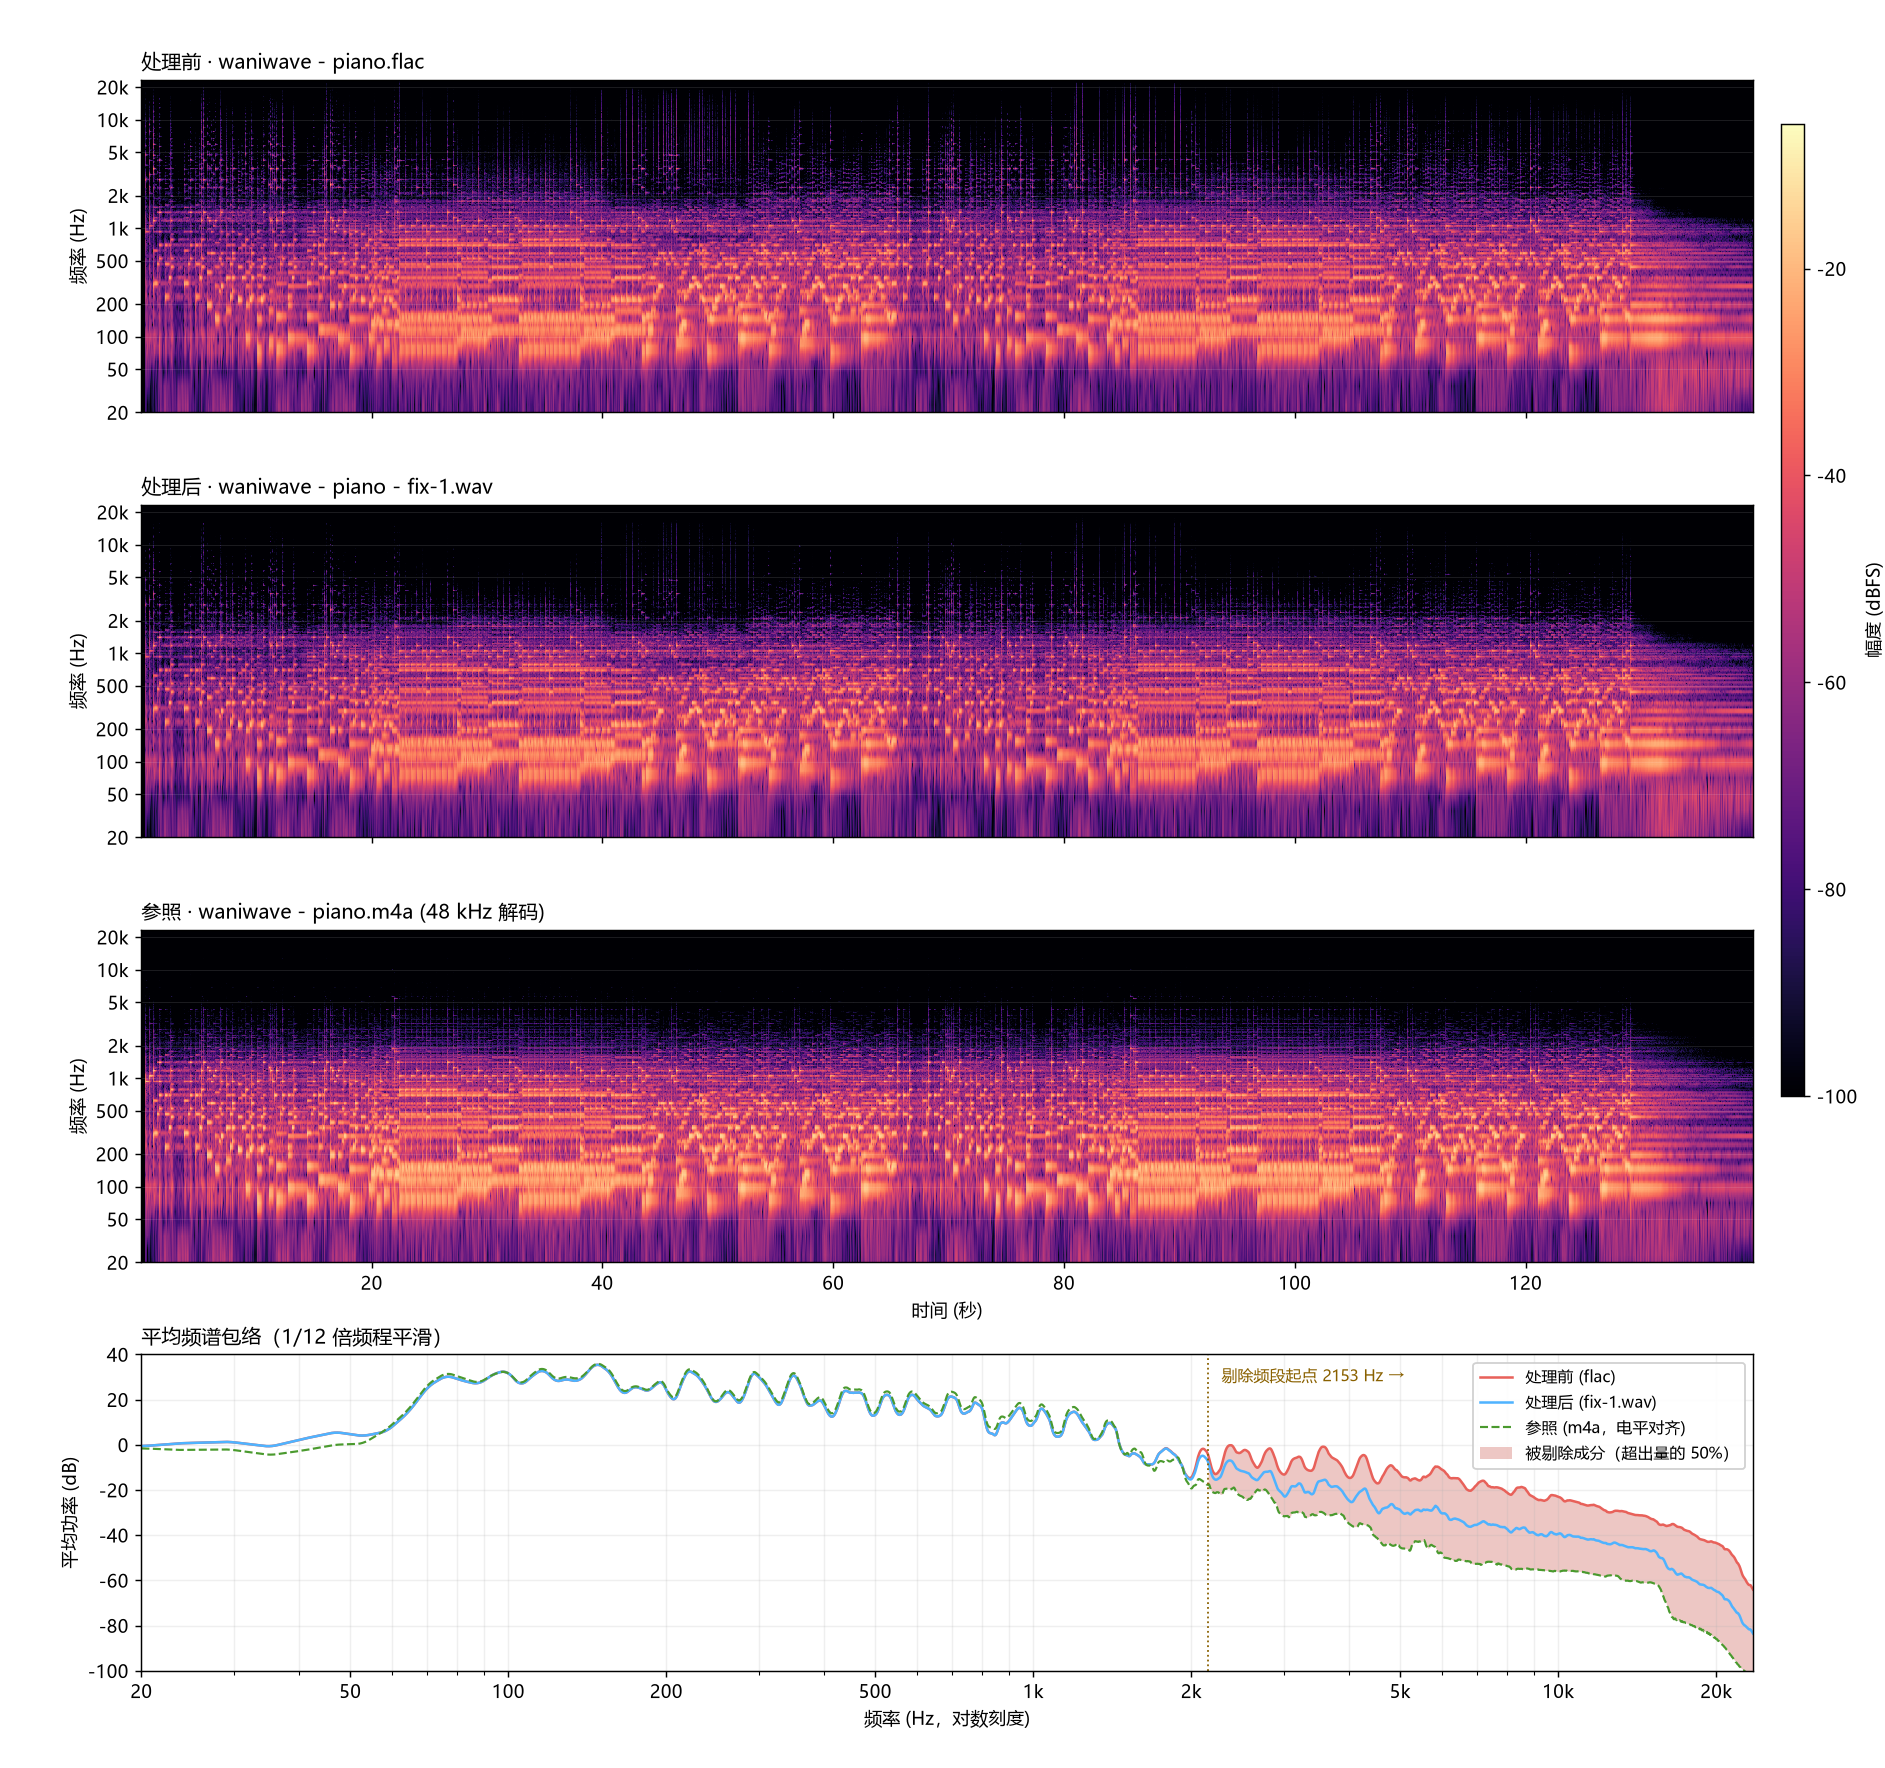
这次听起来就好了不少,这也能从频谱图上印证:原本高频的一堆竖线被减弱了,而整数倍的谐波则被保留(相当于高频部分的亮点)。在我提出如果还不满意就让DeepSeek扒出midi,然后用西贝柳斯重新采样的提案后,我们二人在凌晨三点一致认为这个效果就可以了。但很快我们发现,原本的压缩不光丢了高频,低频也被压缩了。
DeepSeek是这样做的:
保留同样的“超出参照”测量,但只剔除 50%:
KEEP = 0.5 f_start = 2153.0 ramp = clip((log2(f / f_start) + 0.30) / 0.60, 0, 1) target = dB_flac − (1 − KEEP) * clip(excess, 0, None) * ramp gain_db = clip(target − dB_flac, −70, 0)- 用 STFT + 4 次迭代让最终 PSD 落到目标;不做陡降,保留连续的钢琴衰减形态。
- 实际斜率约 −14.5 dB/oct(2–4 kHz → 8–12 kHz),16 kHz 以上平滑延续,没有砖墙式截止。
KEEP可调:0.35剔除 65%(更暗),0.7剔除 30%(更亮,接近明亮钢琴的天然形态)。这样一来处理完成后,高频的几个频段虽然也有所下压,但始终比原始音频的功率高,起到了补全高频,但不会放大无关频率的效果。
提高低频
有了前面的经历,想必提高低频这种事情应该不难,再不济把文件拖进Audition里画个增益曲线就好了。于是我们就让DeepSeek放心大胆的做了:
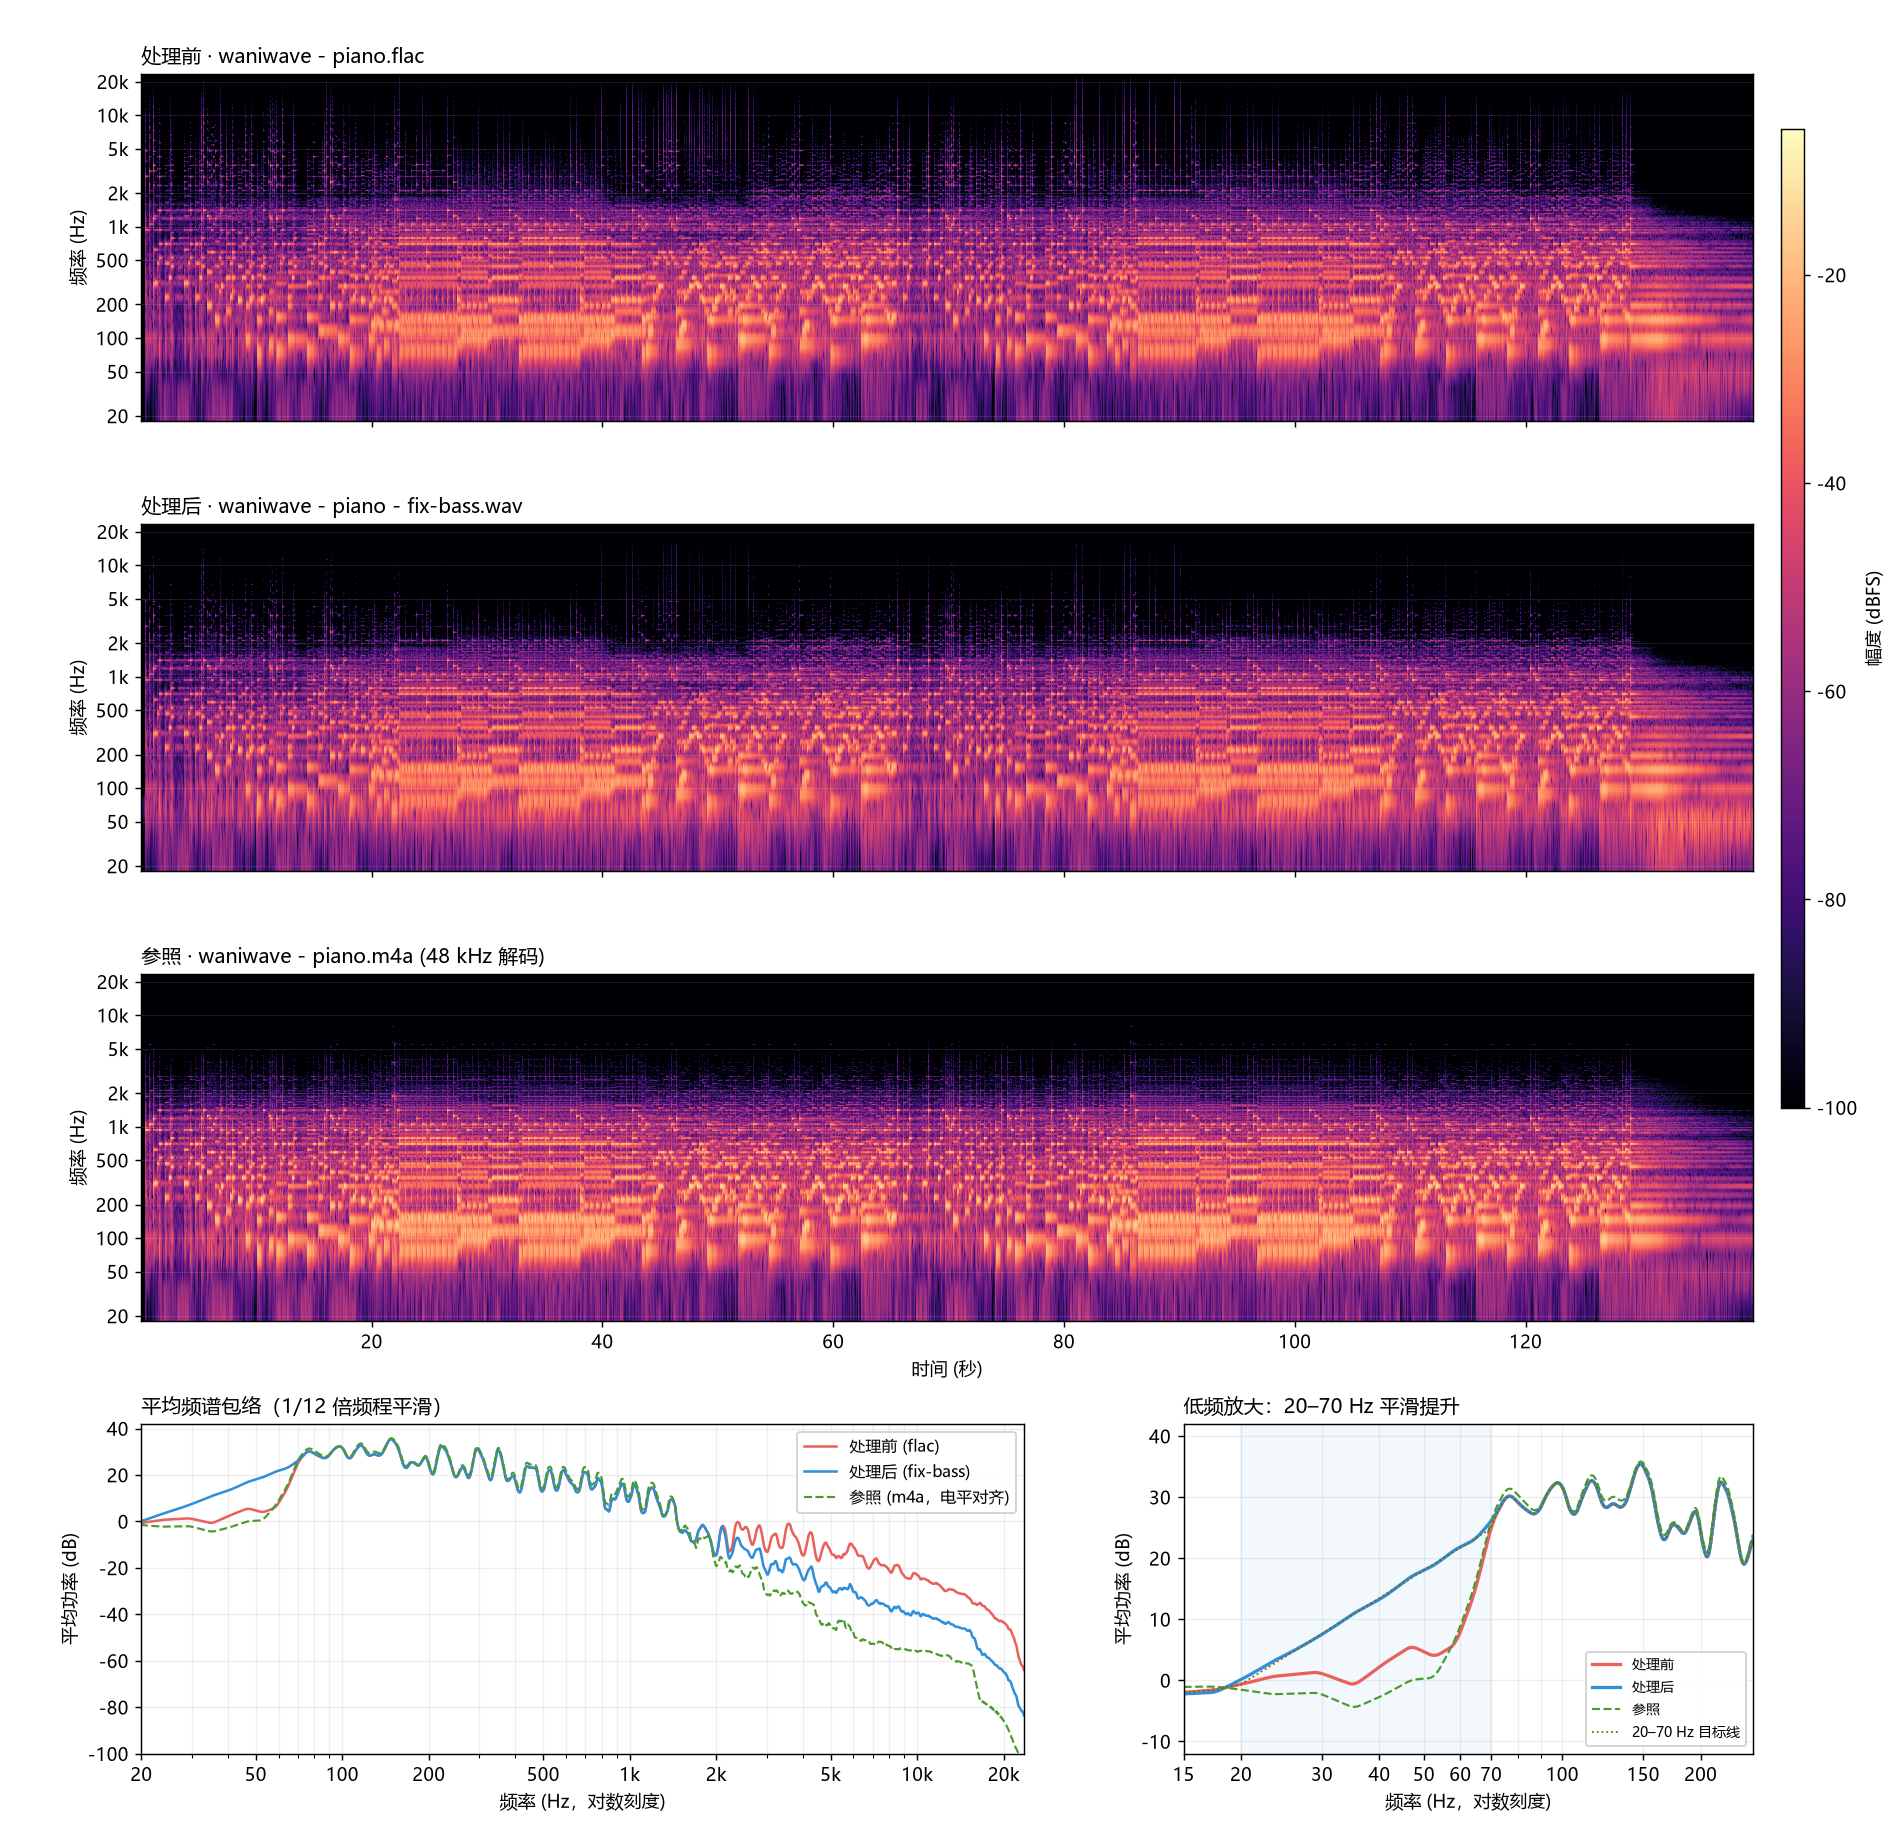
?
。。。。。。
在沉默了一阵后,我们发出了一致的提问:为什么功率是从20Hz到70Hz近似拉了一条斜线上去的?
询问了DeepSeek后它决定调整策略,于是有了最终成品:
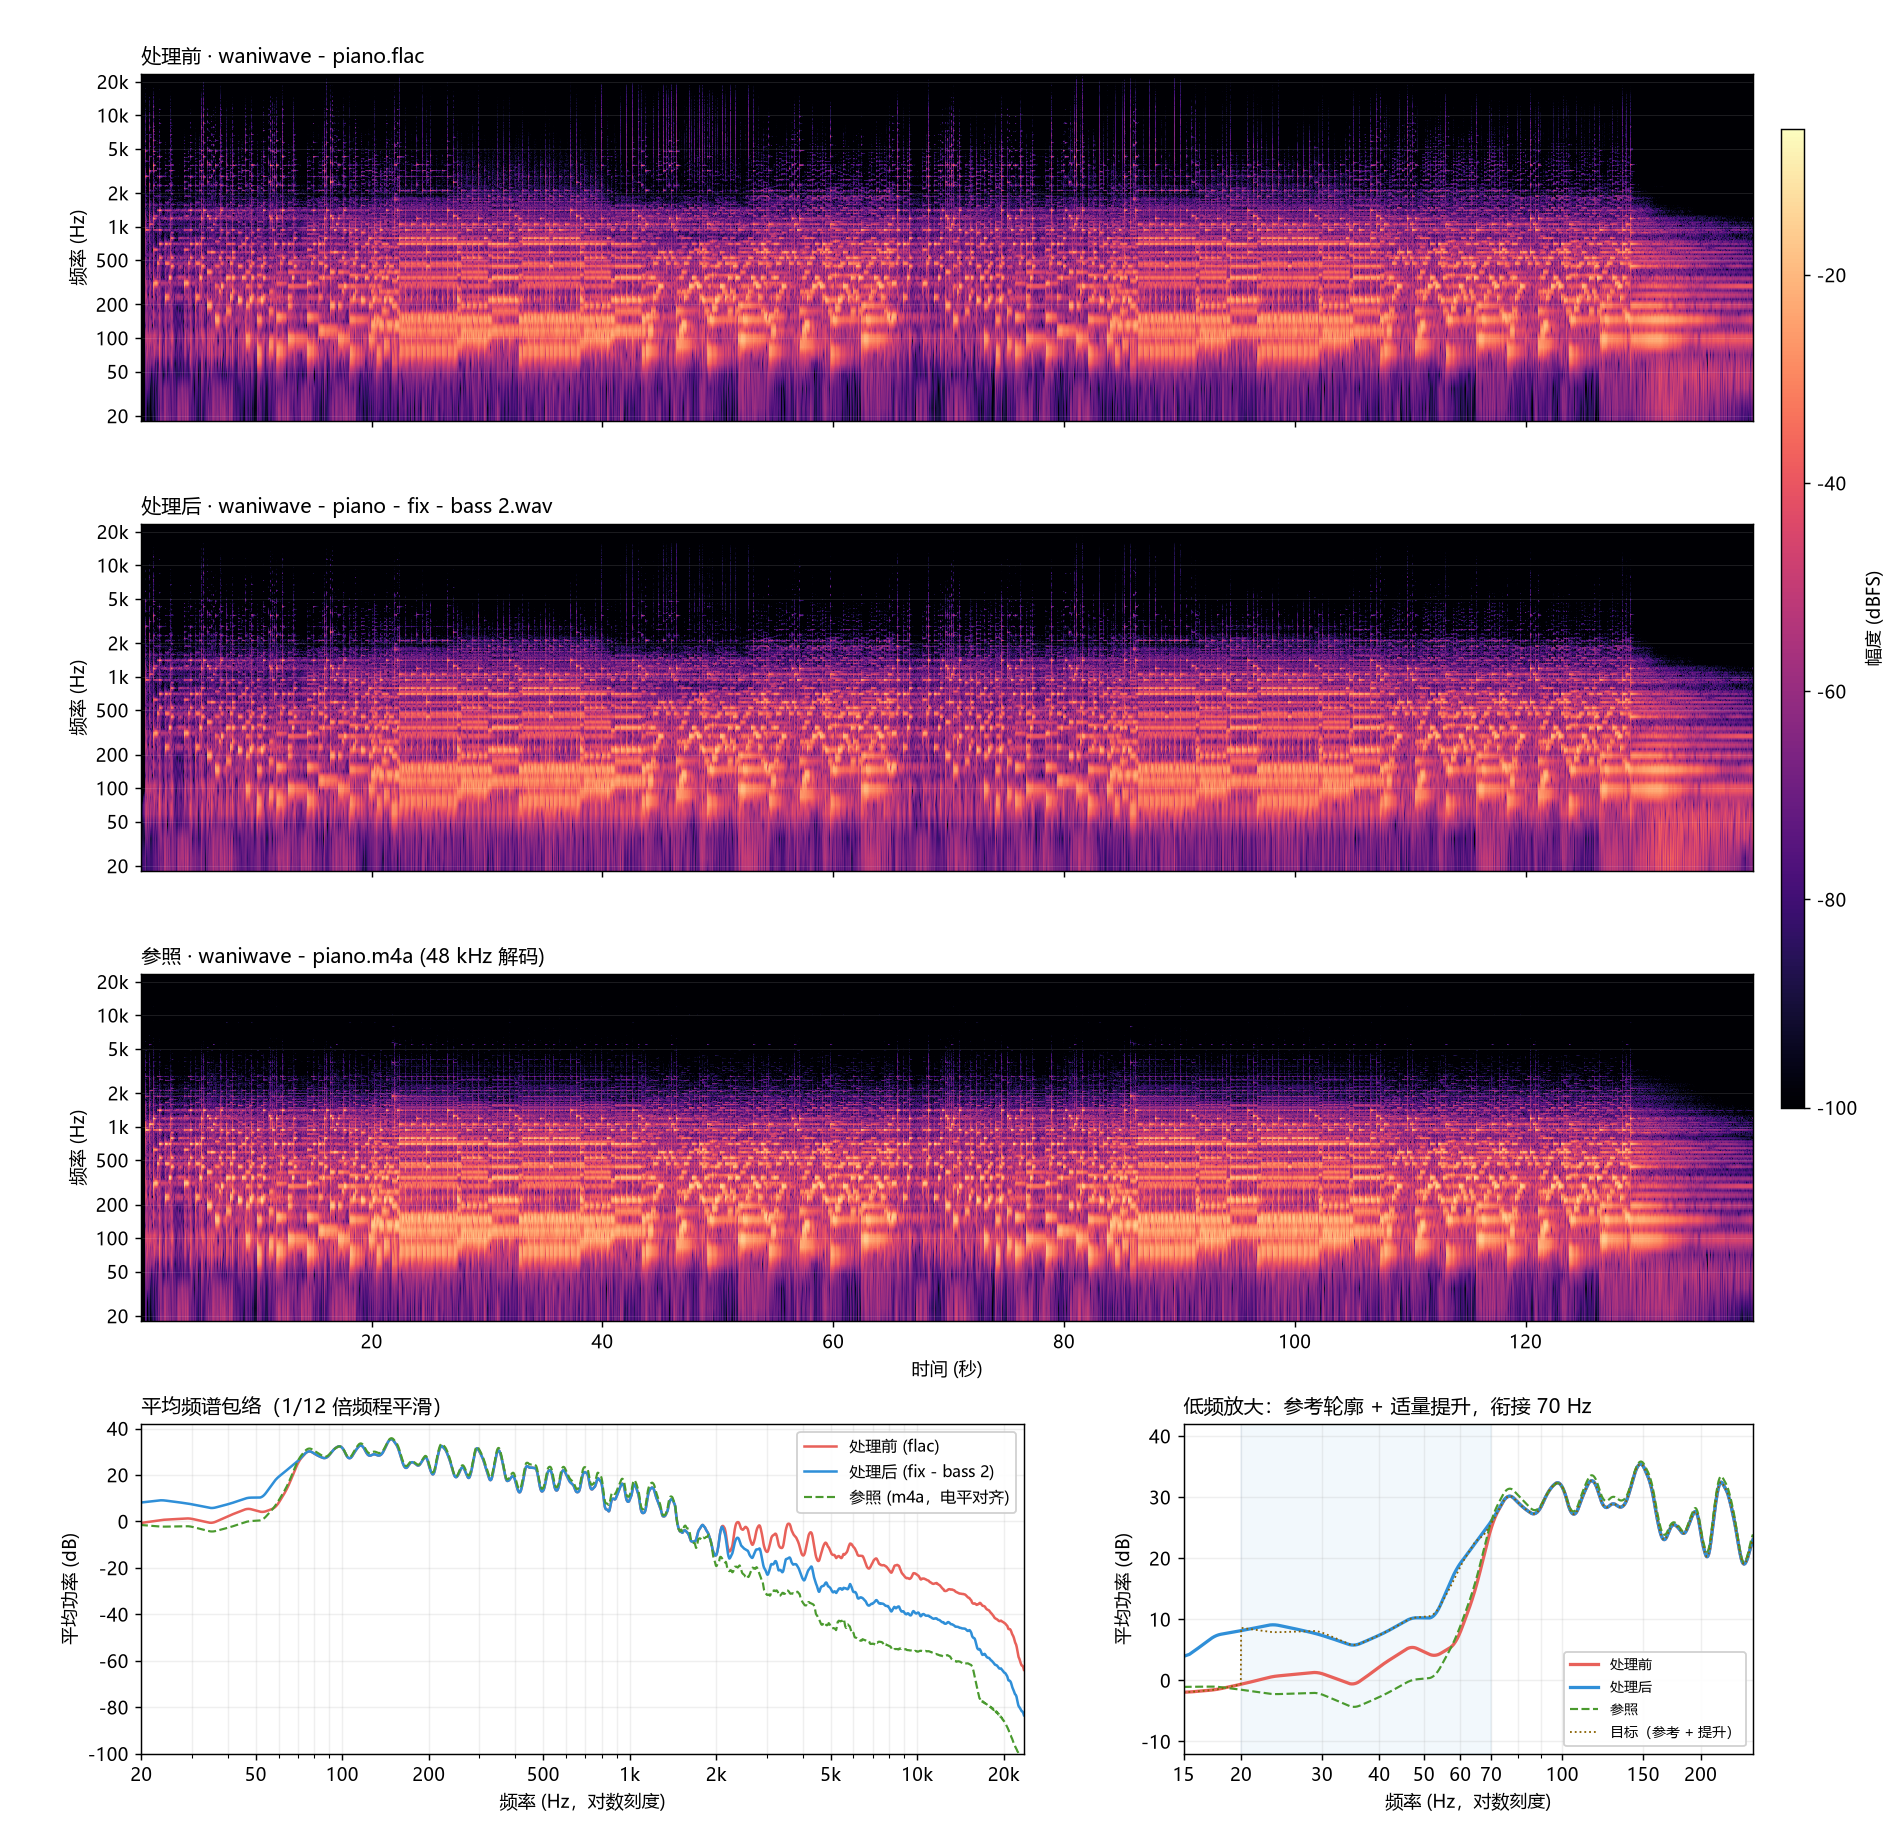
这样才对嘛。最终输出的效果在高频、低频上都有所提升,感觉算是成功了吧。
DeepSeek的第一次尝试:
- 高频沿用
fix-1的 50% 剔除策略。20–70 Hz 目标定为对数频率上的直线:
e20 = dB_flac(20 Hz), e70 = dB_flac(70 Hz) line = e20 + (e70 − e20) * log2(f/20) / log2(70/20) target = max(line, dB_flac) # 只提升,不衰减- 增益上限
BASS_MAX = 15 dB;18 Hz 以下不动;70 Hz 处回落到 0。第二次尝试:
- 高频仍沿用
KEEP=0.5。低频改为“以参照轮廓为底,叠加 +6 dB”:
LIFT = 6.0
F_FULL, F_ZERO = 58.0, 71.0
taper = 1                                              # f <= 58
        cos 衰减                                      # 58 < f < 71
        0                                             # f >= 71
T_low = dB_ref + LIFT * taper
blend = smoothstep(log2(f/64)/log2(72/64))             # 64–72 Hz 过渡到文件自身
T_low = T_low * (1 − blend) + dB_flac * blend
target = max(T_low, dB_flac)                          # 只提升
后记
以上就是音频后处理的过程了。虽然我全程思路在线,但你要问我怎么在Audition里处理,用什么效果器怎么调,那我是真不知道。如果要是我的话,大概就会选择让LLM把谱子扒出来,然后放到雅马哈的电钢琴上播放并录音了。但LLM确实改变了这个局面。之前在讨论AI在游戏领域的应用时,有一个比较经典的笑话:“本以为AI能够补足独立开发者的短板,让游戏开发更顺利;没想到AI就是开发者最长的板”。这确实在讽刺vibe coding,不过从本文的角度来看,LLM或许确实补足了我和朋友在音频处理上的短板。我们能听出有问题,但不知道该如何调整,不知道该如何实现。但在我们描述的需求和大概方向之后,LLM就能顺着我们的意思做出我们想要的东西。或许在专业录音室或者音乐人眼中,这个结果并不怎么样,但对于凌晨四点想要迫切地把这个事儿弄完然后赶快睡觉的两个人来说,这已经是放以前想都不敢想的事情了。
虽然我对LLM辅助编程已经习以为常了,但编程之外的用途还是每次都能让我眼前一亮。以上就是本文的全部内容了。正如开头所说,没什么特别的干货,就是觉得挺有意思的,于是便分享给大家。
-全文完-

【歪门邪道】基于LLM辅助的音频后处理 由 天空 Blond 采用 知识共享 署名 - 非商业性使用 - 相同方式共享 4.0 国际 许可协议进行许可。
本许可协议授权之外的使用权限可以从 https://skyblond.info/about.html 处获得。